1 Mio. €
Jährliche Einsparungen für europäische Kunden
Durch die Optimierung von Softwarelizenzkosten haben wir für mehrere europäische Organisationen über 1 Mio. € an jährlichen Einsparungen realisiert.
DNA Solutions entwickelt Datenplattformen und migriert bestehende Datenumgebungen. Gemeinsam mit Ihren Teams arbeiten wir an Datenpipelines, Validierung und Analysen, damit sie die Ergebnisse verstehen und die Plattform weiterentwickeln können.
Eine Datenmigration braucht mehr als ein neues Zielsystem. Gemeinsam mit Ihrem Team prüfen wir Quellen und Transformationen, vergleichen Ergebnisse und untersuchen Abweichungen vor dem Einsatz im Reporting. Data Engineering und Datenanalyse entstehen zusammen. Wissenstransfer hilft Ihrem Team, die Pipelines zu warten und die Ergebnisse einzuordnen.
Wir entwickeln Technologie mit messbarem Beitrag zu Ihrem Geschäftsergebnis. Europäische Unternehmen vertrauen uns extreme Datenvolumen und kritische Finanz-Pipelines an.
Ein Senior-Team aus Ingenieuren und Consultants, verteilt über Europa.
Durch die Optimierung von Softwarelizenzkosten haben wir für mehrere europäische Organisationen über 1 Mio. € an jährlichen Einsparungen realisiert.
Wir haben eine von Deloitte geprüfte Billing-Plattform gebaut und betreiben sie bis heute: 300 Mio. € an geprüften Transaktionen, jeden Monat.
Mehrere Kunden arbeiten seit sechs Jahren mit DNA Solutions. Wir entwickeln und betreuen ihre Software weiter, wenn sich ihre Anforderungen verändern.
Eine Datenplattform ist nur so gut, wie sie an einem vollen Tag ist. So bauen wir sie, damit sie unter Last schnell und kontrolliert bleibt.
Wir entwerfen Data Lakes und Analyseumgebungen nach den Quellen, Abfragemustern und Wartungsanforderungen Ihres Teams. Speicher und Verarbeitung werden gemeinsam bewertet. Die Architektur muss auch Prüfungen ermöglichen, mit denen Herkunft und Transformation der Daten nachvollziehbar bleiben. Dabei besprechen wir auch die Auswirkungen späterer Änderungen auf die tägliche Arbeit Ihres Teams.
Wir entwickeln Dashboards für die Entscheidungen Ihrer Teams. Kennzahlen definieren wir gemeinsam und vergleichen sie mit den zugrunde liegenden Datensätzen. Die Aktualisierungsfrequenz richtet sich nach dem Bedarf und den Grenzen der Quellen. Prüfungen machen verzögerte oder widersprüchliche Daten sichtbar. Die beteiligten Teams prüfen die Anforderungen gemeinsam und halten offene Punkte für die nächste Entscheidung fest.
Wir entwickeln Pipelines, um Daten aus bestehenden Systemen zu übernehmen und für Analysen zu transformieren. Validierungsregeln, Fehlerbehandlung und Prüfungen der Verarbeitung helfen bei der Untersuchung von Abweichungen. Batch- oder Streaming-Verarbeitung richtet sich nach der erforderlichen Aktualität und den verfügbaren Quellen.
Gemeinsam mit Ihrem Team klären wir Zugriffsregeln, Datendefinitionen und die Verantwortung für die Wartung. Dokumentation und Wissenstransfer helfen Analysten und Ingenieuren, die Pipelines zu verstehen und weiterzuentwickeln. Governance-Anforderungen werden für den Projektumfang vereinbart. Offene Fragen werden mit den zuständigen Personen besprochen und fließen in die nächsten Arbeitsschritte ein.
DNA Solutions entwickelt komplette Datenplattformen für Unternehmen mit hohen Datenvolumen. Von der Cloud-Migration über Vektorsuche bis zur Echtzeit-Ingestion: Unsere Architekturen machen aus fragmentierten Daten eine schnelle, kontrollierte Abfrageumgebung.
Projekt besprechenMigration von Oracle- und SAP-Workloads auf cloud-native Data Lakes, parallel validiert bis zum Cutover. Vendor-Lock-in beseitigt, Abfragezeiten von Tagen auf Stunden verkürzt.
Aufbau von Vektordatenbanken für semantische Suche und Retrieval über Unternehmensdokumente und operative Daten. Oft kombiniert mit unseren KI/ML-Projekten, damit Assistenten auf Ihren eigenen, kontrollierten Daten arbeiten.
ETL-, ELT- und Streaming-Pipelines auf Apache Kafka und Airflow für Echtzeit-Ingestion über viele Quellen gleichzeitig. Schema-Validierung und Retry-Strategien verhindern, dass ein fehlerhafter Feed die Plattform beschädigt.
Daten sind in Telekommunikation, Maut und Handel inkompatibel strukturiert. Der Plattformkern ist gemeinsam; die Quellen und Modelle darauf sind sektorspezifisch.
OSS/BSS-Daten, Charging Records und Analytics für audiovisuelle Plattformen, vereint in einer Abfrageumgebung für Betreiber mit Millionen von Teilnehmern.
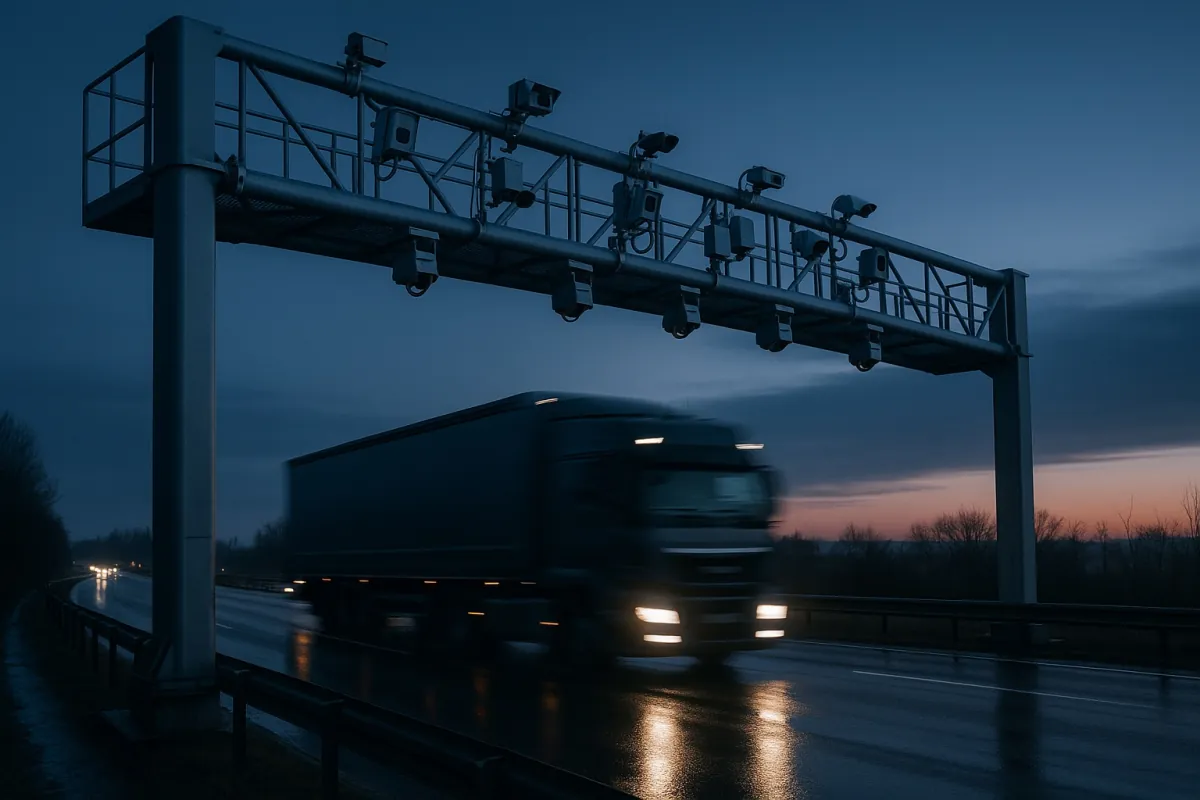
Maut-, Transaktions- und Sensordaten in einer Analyseplattform vereint: Aus fragmentiertem Reporting wird eine einzige, konsistente operative Sicht.
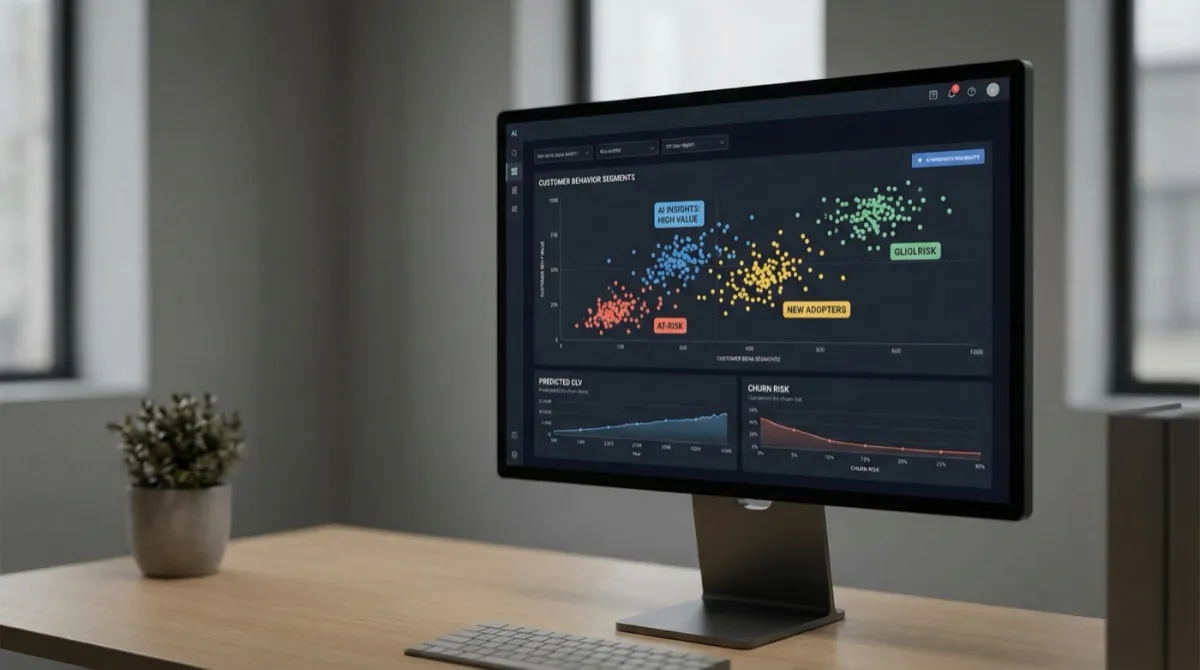
Verkaufs-, Bestands- und Lieferkettendaten für das operative Reporting vereint, mit Echtzeit-Dashboards auf Live-Daten statt unverbundener Exporte.
Wie wir Unternehmensdaten für europäische Betreiber vereinen und migrieren.
Ausgewählte Bewertungen von Kunden und Partnern über die Zusammenarbeit mit DNA Solutions.
"Collaboration with DNA is great they listen and know our industry inside out and they are both reactive to requests and proactive with ideas and proposals"
Häufige Fragen, bevor Daten auf einer Plattform konsolidiert werden.
DNA Solutions entwickelt Datenplattformen, die bestehende Quellen für Reporting und Analysen zusammenführen. Die Arbeit kann Migration, Datenpipelines, Validierung und Dashboards umfassen. Ausgangspunkt sind Ihre vorhandenen Systeme und die Fragen Ihrer Teams. Architektur und Werkzeuge richten sich nach diesen Anforderungen.
Wir definieren mit Ihrem Team die Vergleiche, prüfen Quell- und Zielergebnisse und untersuchen Abweichungen. Die Validierung kann Datensätze, Transformationen und betriebliche Summen umfassen. Diese Prüfungen unterstützen Korrekturen und die Entscheidung zur Umstellung. Außerdem vereinbaren wir die Kontrolle der Datenqualität nach der Migration.
Wir implementieren Vektordatenbanken für semantische Suche und Retrieval über Unternehmensdokumente und operative Daten, oft im Rahmen unserer KI/ML-Projekte. Ihre Teams können unstrukturierte Inhalte damit nach Bedeutung abfragen statt nach exakten Schlagwörtern, und es entsteht die Retrieval-Schicht, die KI-Assistenten brauchen, um aus Ihren eigenen, kontrollierten Daten zu antworten statt aus generischen Quellen. Wir embedden Ihre Dokumente und Datensätze, legen die Vektoren neben den strukturierten Daten ab, die bereits in der Plattform liegen, und binden das Retrieval an die Anwendungen an, die es konsumieren. Weil die Vektor-Schicht in derselben kontrollierten Umgebung sitzt, gelten Zugriffskontrolle und Lineage für sie genauso wie für den Rest Ihrer Daten. In der Praxis ist das der Unterschied, ob ein interner Assistent einen echten Vertrag, ein Ticket oder einen Bericht zitiert oder eine plausible Vermutung.
Wir klären Zugriffsanforderungen, Datenverantwortung und die nötigen Kontrollen für Ihre Reporting-Umgebung. Die Dokumentation beschreibt Quellen, Transformationen und Betriebsabläufe. Wir besprechen sie mit Ihren Ingenieuren, damit diese die Plattform warten und die Auswirkungen späterer Änderungen beurteilen können.