1 Mio. €
Jährliche Einsparungen für europäische Kunden
Durch die Optimierung von Softwarelizenzkosten haben wir für mehrere europäische Organisationen über 1 Mio. € an jährlichen Einsparungen realisiert.
Machine-Learning-Modelle auf Unternehmensdaten, um Wartung und Umsatztrends vorherzusagen. DNA Solutions baut Prognose-Pipelines auf bestehenden Datenplattformen, von Wartungsfenstern im Fuhrpark bis zur Kundenabwanderung im Telekom-Geschäft.
DNA Solutions baut Predictive Analytics auf den Datenplattformen, die wir bereits für europäische Betreiber liefern. Modelle werden auf Ihren historischen Betriebsdaten trainiert, gegen vergangene Ergebnisse validiert und in bestehende Pipelines deployt.
Prognosen zu Geräteausfällen, Nachfrageschwankungen und Kundenabwanderung erreichen die Teams, die danach handeln, in Systemen, die sie bereits nutzen. Ein Modell, das driftet, wird markiert und nachtrainiert, statt still zu degradieren.
Wir entwickeln Technologie mit messbarem Beitrag zu Ihrem Geschäftsergebnis. Europäische Unternehmen vertrauen uns extreme Datenvolumen und kritische Finanz-Pipelines an.
Ein Senior-Team aus Ingenieuren und Consultants, verteilt über Europa.
Durch die Optimierung von Softwarelizenzkosten haben wir für mehrere europäische Organisationen über 1 Mio. € an jährlichen Einsparungen realisiert.
Wir haben eine von Deloitte geprüfte Billing-Plattform gebaut und betreiben sie bis heute: 300 Mio. € an geprüften Transaktionen, jeden Monat.
Mehrere Kunden arbeiten seit sechs Jahren mit DNA Solutions. Wir entwickeln und betreuen ihre Software weiter, wenn sich ihre Anforderungen verändern.
Eine Prognose ist erst nützlich, wenn ein Team ihr genug vertraut, um danach zu handeln. So bringen wir ein Modell an diesen Punkt.
Predictive Analytics beginnt bei den Betriebsdaten, die Sie bereits erfassen: Sensor- und Nutzungslogs, Abrechnungsdaten, Wartungshistorie. Bevor ein Modell trainiert wird, prüft unser Team die verfügbaren Daten und ihre Qualität und grenzt dann ein, welche Prognosen darauf machbar sind und welche zuerst zusätzliche Erfassung brauchen.
Eine Prognose ist nur nützlich, wenn sie hält. Jedes Modell wird vor dem Produktivgang gegen historische Ergebnisse validiert: vorhergesagte Ausfälle gegen tatsächliche Ausfälle, prognostizierte Nachfrage gegen erfasste Nachfrage. Die Genauigkeit wird über die Zeit verfolgt, damit das Modell nachtrainiert werden kann, wenn sich der Betrieb verändert, und damit Teams wissen, wie viel Vertrauen sie in jede Vorhersage setzen können.
Die Modelle laufen in bestehenden Daten-Pipelines und den Systemen, die Ihre Teams bereits nutzen. Wartungspläne reagieren vor Ausfällen, Kapazitätsplanung nutzt Nachfrageprognosen und Retention-Teams erhalten Churn-Scores. Jeder Output erscheint dort, wo Entscheidungen fallen und direkt gehandelt werden kann, statt in einem separaten Dashboard.
Wir trainieren eigene Modelle, wo der Use Case es verlangt, und nutzen etablierte Machine-Learning-Bibliotheken und Managed-Cloud-Services, wo sie passen. Die Wahl folgt dem Problem, damit die Prognose-Schicht wartbar bleibt und Ihr Team sie nach dem Produktivgang erweitern kann. Wo laufendes Tuning und Retraining nötig sind, übernehmen wir das als Managed Service oder übergeben es bei der Übergabe an Ihre Ingenieure.
DNA Solutions baut Prognosemodelle auf den Datenplattformen, die wir für europäische Betreiber liefern. Von der Wartungsprognose über Churn-Scoring bis zur Nachfragemodellierung läuft jedes Modell dort, wo operative Teams ohnehin arbeiten.
Projekt besprechenModelle auf Sensor- und Wartungsdaten prognostizieren Geräteausfälle frühzeitig. Concreteasy, unsere Plattform für große Fahrzeugflotten, koordiniert Wartung und Disposition und zeigt die Datenarchitektur, auf der solche Prognosen produktiv laufen.
Churn-Modelle, trainiert auf Nutzungs- und Abrechnungsdaten, bewerten Konten nach Abwanderungsrisiko. Gebaut auf den Telekom-Daten-Pipelines, die wir für europäische Betreiber liefern, sodass Retention-Teams die Scores dort erhalten, wo sie ohnehin arbeiten.
Nachfrageprognosen und Umsatzprojektionen aus historischen Nutzungsdaten. Die Modelle stützen Kapazitätsplanung, Preisentscheidungen und Revenue Assurance in Umgebungen mit hohem Transaktionsvolumen.
Flotte, Telekommunikation und Handel prognostizieren unterschiedliche Dinge aus unterschiedlichen Daten. Ein Kern für Modellierung und Validierung, angepasst an den Betrieb jedes Sektors.
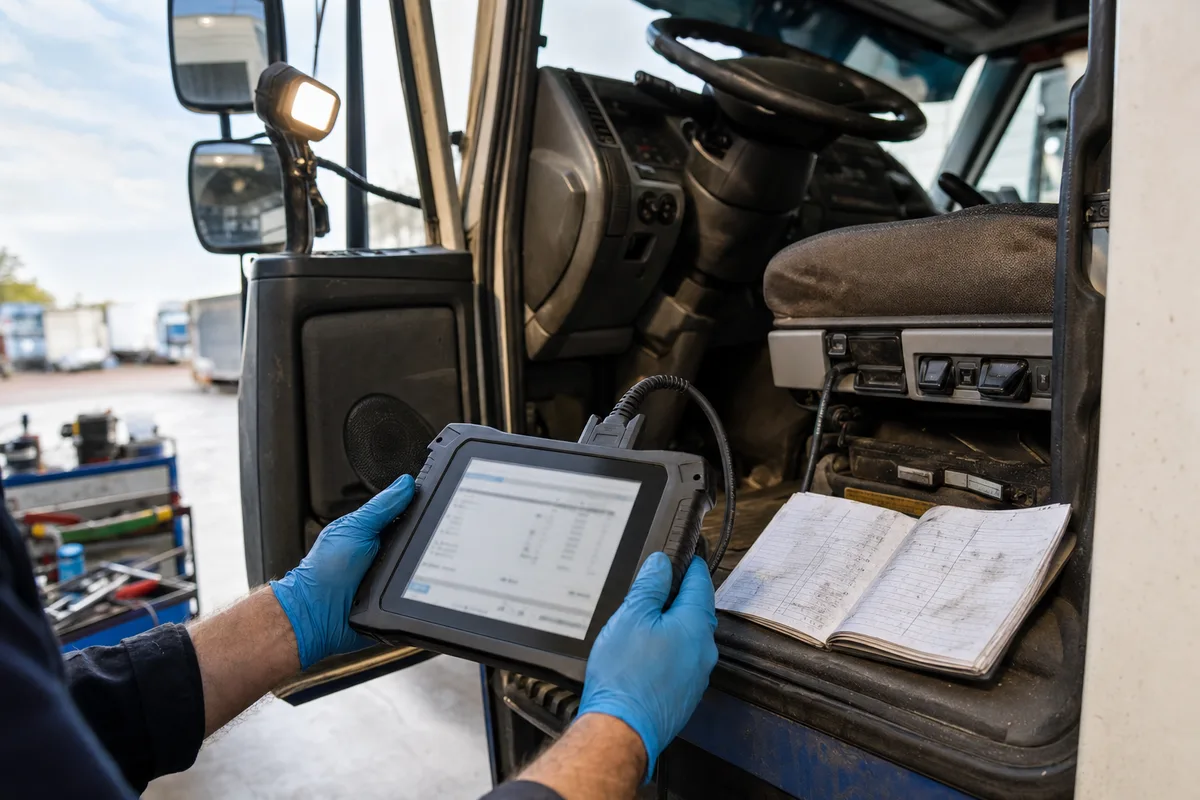
Prädiktive Wartung und Dispositionsprognosen für Fahrzeugflotten. Concreteasy, von unserem Team gebaut, ist auf den Betrieb großer Flotten ausgelegt und zeigt die Flottendaten-Architektur, auf der diese Arbeit aufsetzt.
Churn-Prognose und Nutzungs-Forecasting auf Telekom-OSS/BSS- und Billing-Daten. Wir liefern Datenplattformen für europäische Telekom-Betreiber.
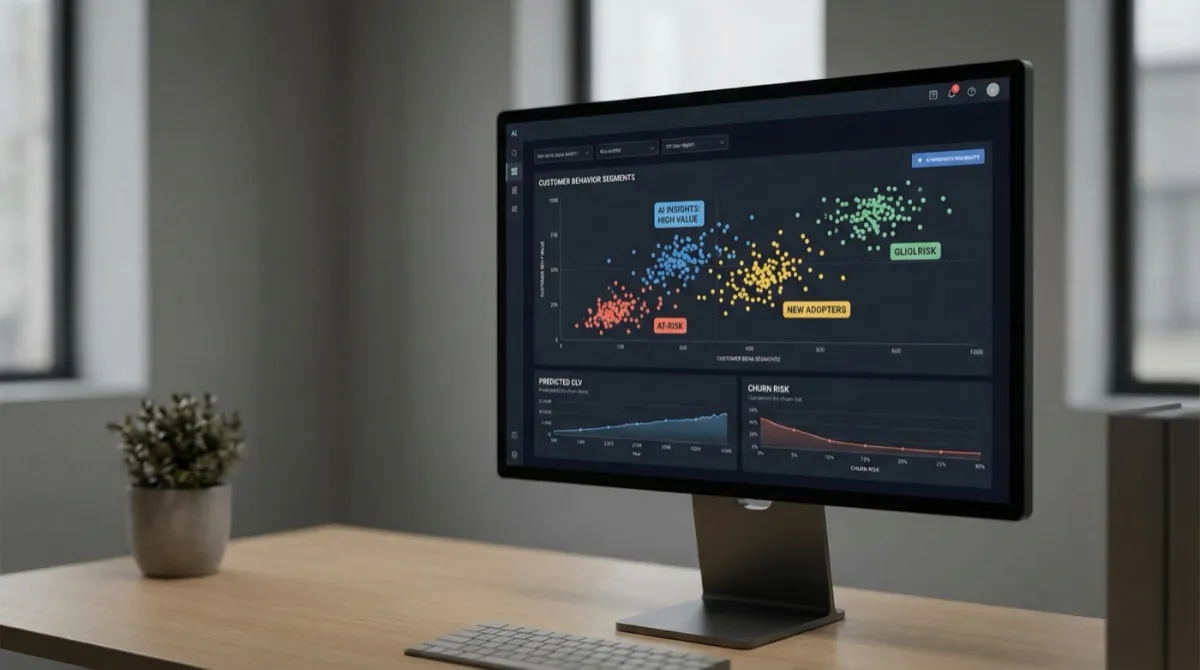
Nachfrageprognosen und Bestandsmodellierung für Handel und Vertrieb, wo Margen wenig Raum für Fehlbestände oder Überbestände lassen.
Wie wir Prognosemodelle und Live-Analytics auf den Betriebsdaten europäischer Unternehmen bauen.
Ausgewählte Bewertungen von Kunden und Partnern über die Zusammenarbeit mit DNA Solutions.
"Collaboration with DNA is great they listen and know our industry inside out and they are both reactive to requests and proactive with ideas and proposals"
"Professionalism, speed, commitment to customer success, deep technical expertise."
"The real connection between sales and project delivery. Most IT companies have salespeople who communicate poorly or not at all with the people who actually build the solution; at DNA, that is really not the case."
Was Teams fragen, bevor sie auf ihren eigenen Betriebsdaten prognostizieren.
Wir starten bei den historischen Betriebsdaten, die Sie bereits erfassen: Wartungslogs, Nutzungsdaten, Abrechnungshistorie, Sensoroutput. Ein Prognosemodell lernt aus der Vergangenheit, um die Zukunft vorherzusagen; Umfang und Qualität dieser Historie zählen daher mehr als jeder einzelne Algorithmus. Der erste Schritt ist eine Prüfung Ihres Datenbestands: wie weit er zurückreicht, wie konsistent erfasst wurde und wo Lücken sitzen. Davon ausgehend grenzt das Team ein, welche Prognosen auf den Daten im heutigen Zustand machbar sind und welche zusätzliche Erfassung oder Instrumentierung brauchen, bevor ein verlässliches Modell trainiert werden kann. So bleibt die Arbeit auf existierende Daten gestützt, und Sie sehen den Umfang klar, bevor die Modellierung beginnt.
Beides. Wir trainieren eigene Modelle, wo der Use Case es verlangt, und nutzen etablierte Machine-Learning-Bibliotheken und Managed-Cloud-Services, wo sie passen. Ein Churn-Score auf Telekom-Konten und eine Ausfallprognose auf Flottensensoren verlangen unterschiedliche Ansätze, die Methode folgt also dem Problem statt einer festen Toolchain. Welchen Weg ein Modell auch nimmt: Es wird in den Daten-Pipelines deployt, die wir ohnehin für europäische Betreiber bauen, sodass Prognosen die handelnden Teams erreichen, ohne dass ein separates Tool zu pflegen wäre. Das Deployment gehört zur Arbeit dazu: Das Modell wird paketiert, im Betrieb überwacht und nachtrainiert, wenn sich Ihr Geschäft verändert. Ihr Team kann diese Schicht nach dem Produktivgang erweitern oder übernehmen.
Jedes Modell wird vor dem Produktivgang gegen historische Ergebnisse validiert. Die Daten werden so geteilt, dass das Modell auf einem Zeitraum trainiert und auf einem anderen getestet wird, den es nie gesehen hat; dann werden seine Vorhersagen mit dem verglichen, was tatsächlich passiert ist: vorhergesagte Ausfälle gegen erfasste Ausfälle, prognostizierte Nachfrage gegen erfasste Nachfrage. Dieser Vergleich liefert eine messbare Fehlerquote statt einer vagen Genauigkeitsbehauptung und setzt die Schwelle, die ein Modell vor dem Livegang nehmen muss. Im Produktivbetrieb wird die Genauigkeit über die Zeit verfolgt, denn der Betrieb verschiebt sich, und ein Modell, das letztes Jahr passte, kann driften. Wenn das passiert, wird es auf aktuelleren Daten nachtrainiert. Das Ziel ist eine Prognose, die belastbar genug ist, um danach zu handeln, mit Grenzen, die den nutzenden Teams explizit gemacht werden.
In den meisten Fällen ja. Die Prognose-Pipelines, die wir bauen, laufen auf der Dateninfrastruktur, die Sie bereits haben, ob das ein Data Warehouse ist, eine Cloud-Plattform oder die operativen Datenbanken hinter Ihren Systemen. Predictive Analytics ist eine Anwendungsschicht auf vorhandenen Daten; eine separate Plattform ist für den Einstieg selten nötig. Wir beginnen mit einer Prüfung dessen, was vorhanden ist und wie die relevanten Daten hindurchfließen, und bauen die Modellierungs- und Deployment-Schicht darum herum. Wo die darunterliegende Plattform zuerst Arbeit braucht, etwa weil Daten über Systeme fragmentiert sind oder noch nicht in der richtigen Granularität erfasst werden, übernehmen unsere Datenanalyse- und Cloud-Leistungen diesen Teil, sodass Sie vorab wissen, ob das Fundament bereit ist oder ein Schritt vor der Prognose nötig wird.