1 Mio. €
Jährliche Einsparungen für europäische Kunden
Bis zu 1 Mio. € jährliche Einsparungen bei Softwarelizenzen für einige unserer Kunden.
KI-Entwicklung beginnt mit Ihrem Prozess, Ihren Daten und bestehenden Systemen. Wir definieren eine sinnvolle Aufgabe, prüfen sie mit repräsentativen Daten und vereinbaren Integration und Betriebsanforderungen.
Ausgangspunkt sind die Daten und die Entscheidung, die das System unterstützen soll. Der vorgeschlagene Umfang kann Dokumentstruktur, Retrieval, Modellbewertung und Integration mit vorhandenen Anwendungen umfassen. Erfolgskriterien, menschliche Prüfung und Betriebsverantwortung werden vor einem breiteren Einsatz definiert.
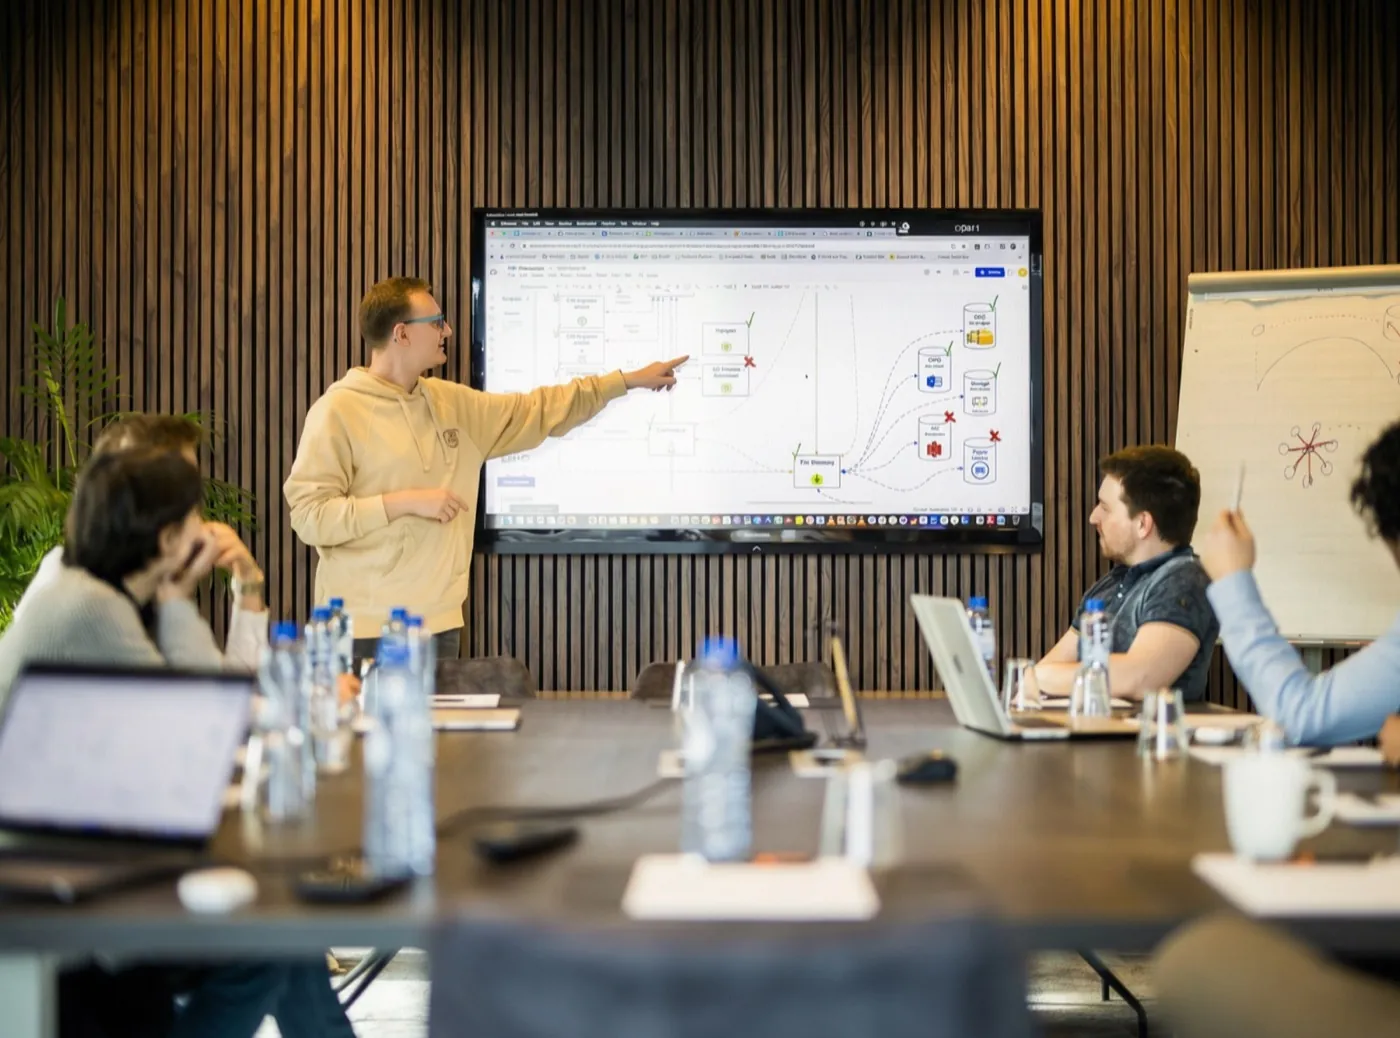
Wir entwickeln Technologie mit messbarem Beitrag zu Ihrem Geschäftsergebnis. Europäische Unternehmen vertrauen uns extreme Datenvolumen und kritische Finanz-Pipelines an.
Ein Senior-Team aus Ingenieuren und Consultants in ganz Europa.
Bis zu 1 Mio. € jährliche Einsparungen bei Softwarelizenzen für einige unserer Kunden.
Wir haben eine von Deloitte auditierte Billing-Plattform aufgebaut und betreiben sie: 300 Mio. € auditierte Transaktionen jeden Monat.
Mehrere Kunden arbeiten seit sechs Jahren mit DNA Solutions. Wir entwickeln und betreuen ihre Software weiter, wenn sich ihre Anforderungen verändern.
Ein Modell in Produktion zu bringen ist vor allem die Arbeit davor und danach. Diese Schritte gehen wir, in dieser Reihenfolge.
Klassifikation und Extraktion werden getrennt anhand repräsentativer Dokumente und vereinbarter Fehlerkriterien geprüft. Vor der Modellwahl erfassen wir Dokumenttypen, Scanqualität und benötigte Ergebnisse. Unsichere Ergebnisse brauchen einen definierten Prüfweg. Die nachgelagerte Integration wird getestet. Ein Klassifikationsbenchmark belegt weder Extraktionsgenauigkeit noch Produktionsreife für den gesamten Prozess.
Machine-Learning-Modelle für operative Prognosen, aufgebaut auf konsolidierten Daten-Pipelines. Wir behandeln zuerst die Datenschicht, dann das Modell, denn ein Prognosemodell ist nur so verlässlich wie die Pipeline, die es speist. Modelle werden auf Ihren eigenen historischen Daten trainiert, validiert und überwacht und bleiben in Ihrer Umgebung, neben den operativen Systemen, die sie unterstützen.
Wir integrieren KI in die Systeme, die Sie bereits betreiben, darunter Oracle und SAP, statt eigenständige Tools daneben zu stellen. Modelle verbinden sich über stabile, dokumentierte Schnittstellen mit Ihren Datenquellen und internen Anwendungen, sodass KI Teil des Produktionspfads wird statt ein paralleles Experiment.
Für regulierte Branchen erfolgt das Deployment in Ihrer Umgebung unter DSGVO- und EU-AI-Act-Vorgaben, ohne Abhängigkeit von externen LLM-Anbietern im Produktionspfad. Dokumente und Embeddings bleiben in Ihrer Infrastruktur, ohne dass Daten an externe LLM-APIs gehen. Wo es passt, betreiben wir Open-Weight-Modelle auf Private Cloud, damit Sie die volle Kontrolle darüber behalten, wo Daten liegen und welche Modellversion in Produktion ist.
Wir entwickeln private KI, die in Ihrer Infrastruktur läuft und sich mit den Systemen verbindet, die Sie bereits betreiben. Von Retrieval-Augmented Generation bis zur Integration individueller Modelle: Unsere Arbeit beginnt an der Datenschicht.
Projekt besprechenRetrieval-Augmented Generation, betrieben in Ihrer eigenen Infrastruktur. Ihre Dokumente und Embeddings bleiben in Ihrer Umgebung, ohne dass Daten an externe LLM-APIs gehen. Geeignet für regulierte Branchen unter DSGVO- und EU-AI-Act-Vorgaben.
Integration von Sprachmodellen in Ihre bestehenden Anwendungen und Workflows. Wir verbinden Modelle mit Ihren Datenquellen, Oracle- und SAP-Systemen und internen Tools, mit der Option, Open-Weight-Modelle auf Private Cloud statt über Drittanbieter-APIs zu betreiben.
Scoping und Machbarkeit für Enterprise-KI-Projekte. Wir bewerten Ihren aktuellen Stack, identifizieren, wo KI messbaren Mehrwert schafft, und definieren die Daten- und Infrastrukturarbeit, die vor jedem Modell ansteht. Für mittelständische Unternehmen bündeln wir dieses Vorgehen in der KI-Beratung für den Mittelstand.
Derselbe Kern aus privatem Deployment und Integration arbeitet in Telekom, Einzelhandel und Maut mit sehr unterschiedlichen Eingangsdaten. Wir passen ihn an die Dokumente und Vorgaben jeder Branche an.
Dokumentklassifikation, OSS/BSS-Datenintegration und Predictive Analytics für Telekommunikationsanbieter, unter anderem im Einsatz bei T-Systems.
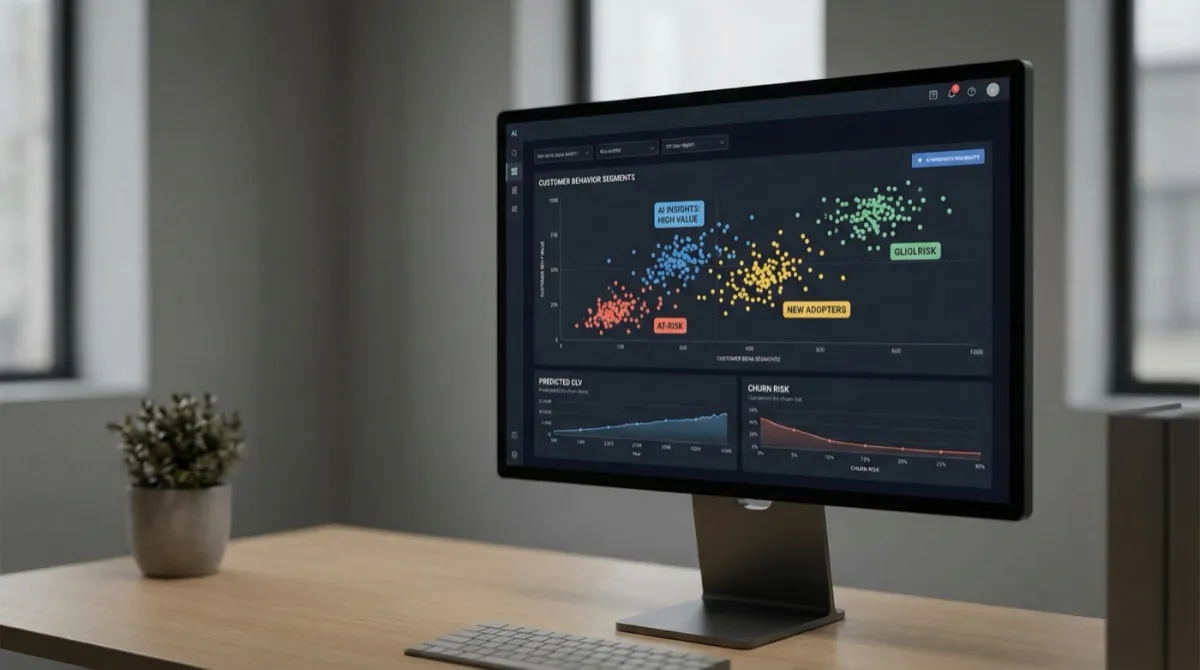
KI-Kundensegmentierung und Bedarfsprognosen für Einzelhandel und Vertrieb, aufgebaut auf konsolidierten Daten-Pipelines.
Predictive Analytics und Dokumentenverarbeitung für Maut- und Straßenbetreiber, integriert mit bestehenden Datenplattformen.
Wie wir private KI- und Machine-Learning-Modelle in der Infrastruktur europäischer Unternehmen betreiben.

Individueller Klassifikator, verglichen mit Azure AI Document Intelligence auf drei Datensätzen. Die Ergebnisse gelten für diese Tests.
94,7 % vs. 84,2 % auf einem der drei Datensätze
Eine semantische Matching-Engine, die über Keywords hinausgeht und Kandidaten per Vektorsuche gegen Rollen rankt.
Vektorsuche statt KeywordsSeite auf EnglischAusgewählte Bewertungen von Kunden und Partnern über die Zusammenarbeit mit DNA Solutions.
"Professionalism, speed, commitment to customer success, deep technical expertise."
"Collaboration with DNA is great they listen and know our industry inside out and they are both reactive to requests and proactive with ideas and proposals"
"The real connection between sales and project delivery. Most IT companies have salespeople who communicate poorly or not at all with the people who actually build the solution; at DNA, that is really not the case."
Die Fragen, die wir am häufigsten hören, wenn KI in einer regulierten Umgebung laufen muss.
Ja. Wir bauen private Deployments, die in Ihrer Umgebung laufen, einschließlich Private RAG, bei dem Ihre Dokumente und Embeddings in Ihrer Infrastruktur bleiben, ohne dass Daten an externe LLM-APIs gehen. So bleiben Ihre Daten unter Ihrer eigenen Governance, und wir können unter DSGVO- und EU-AI-Act-Vorgaben deployen. Wo es passt, betreiben wir Open-Weight-Modelle auf Ihrer Private Cloud, statt Drittanbieter-APIs aufzurufen, damit Sie kontrollieren, welche Modellversion in Produktion ist und wo Daten liegen. Das Retrieval läuft gegen Ihren eigenen Dokumentenbestand, und der Zugriff folgt denselben Berechtigungen wie in den Quellsystemen, ein Nutzer sieht also nur, was er ohnehin sehen darf. Zum Start grenzen wir typischerweise einen überschaubaren Anwendungsfall ab, belegen Genauigkeit und Datengrenzen und erweitern von dort.
Ja. DNA Solutions integriert Sprachmodelle und Machine Learning in die Systeme, die Sie bereits betreiben, darunter Oracle und SAP, statt eigenständige Tools daneben zu stellen. Modelle verbinden sich über stabile, dokumentierte Schnittstellen mit Ihren Datenquellen und internen Anwendungen, sodass KI Teil Ihres Produktionspfads wird statt ein paralleles Experiment. Unser Team bringt langjährige Erfahrung in der Integration von Enterprise-Datenplattformen bei europäischen Telekom- und Infrastrukturkunden mit. Damit binden wir Modelle an gewachsene Systemlandschaften an, ohne die Systeme darüber zu stören. Die Integrationsschicht behandeln wir als eigenständiges Produkt, mit versionierten Schnittstellen und Monitoring, sodass ein Modell aktualisiert oder ersetzt werden kann, ohne die Systeme drumherum neu zu verdrahten. Die Datenschicht kommt zuerst: Wir konsolidieren die Eingangsdaten, von denen ein Modell abhängt, bevor wir es anbinden.
DNA Solutions entwickelt individuelle Dokumentklassifikatoren und prüft sie anhand repräsentativer Daten. Im veröffentlichten Canon-Benchmark erzielte der Klassifikator auf zwei von drei getesteten Datensätzen höhere Werte als Azure AI Document Intelligence; auf dem dritten gab es einen Gleichstand. Die 94,7 % gegenüber 84,2 % beziehen sich auf einen Datensatz. Hosting, OCR, Integration und Compliance sind getrennt zu bewerten.
Wir bauen private Deployments für DSGVO- und EU-AI-Act-Vorgaben, ohne Abhängigkeit von externen LLM-Anbietern im Produktionspfad. Daten bleiben in Ihrer Umgebung, Modellversionen sind festgeschrieben und dokumentiert, und die Integrationsschicht hält die Audit-Lineage konsistent mit dem Rest Ihres Stacks, sodass ein externer Prüfer nachvollziehen kann, welches Modell und welche Daten ein bestimmtes Ergebnis erzeugt haben. Datenhoheit ist der Ausgangspunkt: Dokumente und Embeddings bleiben in Ihrer Infrastruktur unter Ihrer eigenen Zugriffskontrolle und verlassen sie nie in Richtung einer Drittanbieter-API. Der EU AI Act bringt je nach Einstufung eines Systems Pflichten zu Dokumentation, Nachvollziehbarkeit und menschlicher Aufsicht mit sich, und festgeschriebene Versionen mit vollständiger Lineage machen diese Pflichten auditierbar. Für regulierte Branchen ist das der Unterschied zwischen einem Experiment und einem System, das im Produktivbetrieb laufen kann.